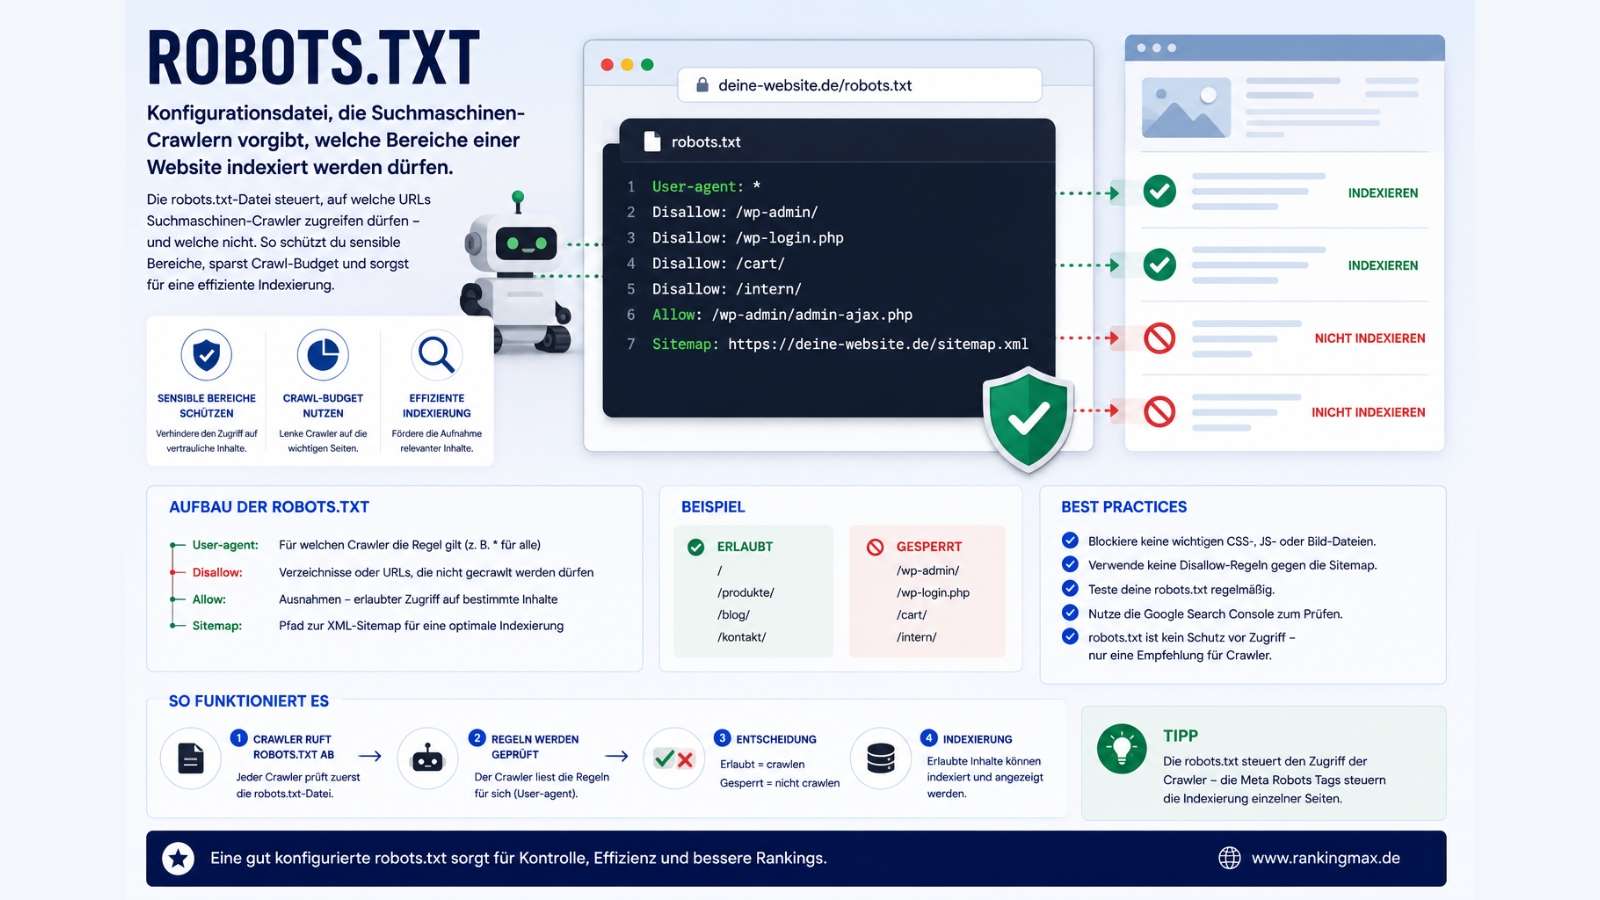
Robots.txt ist eine Textdatei im Stammverzeichnis einer Website, die Suchmaschinen-Crawlern mitteilt, welche Bereiche sie durchsuchen dürfen. Die Datei folgt dem Robots Exclusion Protocol (REP) nach RFC 9309 und steuert damit den Crawler-Zugriff, aber nicht die Indexierung. Seriöse Bots wie der Googlebot befolgen die Regeln, verpflichtend sind sie jedoch nicht.
Was ist robots.txt?
Robots.txt ist eine öffentlich einsehbare Textdatei, die im Stammverzeichnis einer Domain liegt, zum Beispiel unter www.beispiel.de/robots.txt. Sie gibt Suchmaschinen-Crawlern wie dem Googlebot vor, welche Verzeichnisse und Dateien sie besuchen dürfen und welche nicht. Google weist ausdrücklich darauf hin, dass robots.txt nicht dazu gedacht ist, Seiten aus der Suche zu entfernen. Dafür ist der noindex-Tag oder ein Passwortschutz zuständig. Die Datei regelt ausschließlich, ob ein Crawler eine Seite überhaupt abruft.
Für Handwerksbetriebe und KMU ist robots.txt vor allem bei WordPress-Websites relevant: Das CMS erzeugt automatisch eine virtuelle robots.txt-Datei, die den Ordner /wp-admin/ sperrt. Wer eigene Regeln braucht, etwa um interne Suchergebnisseiten oder Staging-Bereiche vom Crawling auszuschließen, legt eine physische Datei im Root-Verzeichnis an oder nutzt ein SEO-Plugin wie Yoast.
Wie funktioniert robots.txt?
Bevor ein Crawler eine Website durchsucht, ruft er zuerst die robots.txt-Datei ab und liest die enthaltenen Regeln. Google cacht den Inhalt in der Regel für 24 Stunden, sodass Änderungen nicht sofort wirksam werden. Findet der Crawler keine Datei (Statuscode 404), geht er davon aus, dass keine Einschränkungen bestehen, und crawlt die gesamte Website.
Wichtig für die Praxis: Eine per Disallow gesperrte Seite kann trotzdem in den Suchergebnissen erscheinen, wenn andere Websites auf sie verlinken. Google kennt dann zwar die URL, aber nicht den Inhalt, weshalb die Seite meist ohne Snippet angezeigt wird. Wer eine Seite vollständig aus dem Index entfernen will, muss sie crawlbar lassen und stattdessen mit einem noindex-Tag versehen.
Aufbau und Syntax einer robots.txt-Datei
Jede robots.txt-Datei besteht aus einem oder mehreren Regelblöcken. Ein Block beginnt mit einer User-agent-Zeile und enthält die dazugehörigen Anweisungen. Google unterstützt offiziell vier Felder. Alle anderen, etwa Crawl-delay, werden ignoriert.
| Direktive | Funktion | Von Google unterstützt |
|---|---|---|
| User-agent | Legt fest, für welchen Crawler die Regeln gelten (* = alle Bots) | Ja |
| Disallow | Sperrt den Zugriff auf einen Pfad | Ja |
| Allow | Erlaubt Zugriff auf einen Pfad innerhalb eines gesperrten Verzeichnisses | Ja |
| Sitemap | Verweist auf die XML-Sitemap der Website | Ja |
| Crawl-delay | Bittet um eine Wartezeit zwischen Anfragen | Nein (Googlebot ignoriert dies) |
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://www.beispiel.de/sitemap_index.xml
Robots.txt erstellen und einrichten – in 4 Schritten
Schritt 1: Datei erstellen
Erstelle eine einfache Textdatei mit dem Namen robots.txt in einem Texteditor wie Notepad oder TextEdit. Verwende kein Textverarbeitungsprogramm wie Word, da dieses unerwünschte Zeichen einfügen kann und speichere die Datei mit UTF-8-Kodierung.
Schritt 2: Regeln definieren
Lege für jeden relevanten Crawler einen User-agent-Block an und ergänze die passenden Disallow- und Allow-Zeilen. Verweise am Ende zusätzlich mit der Sitemap-Zeile auf die XML-Sitemap der Website.
Schritt 3: Datei hochladen
Lade die fertige Datei per FTP oder über das Hosting-Backend in das Stammverzeichnis der Domain hoch. Die Datei muss unter www.beispiel.de/robots.txt erreichbar sein Achtung: nicht in einem Unterverzeichnis ablegen.
Schritt 4: Datei testen
Rufe die Datei direkt im Browser auf, um zu prüfen, ob sie öffentlich zugänglich ist. Kontrolliere anschließend im robots.txt-Bericht der Google Search Console, ob Google die Datei fehlerfrei verarbeitet.
Robots.txt vs. Noindex-Tag
| Kriterium | robots.txt | Noindex-Tag |
|---|---|---|
| Steuerungsebene | Crawling (Zugriff des Bots) | Indexierung (Aufnahme in den Index) |
| Wirkung bei Verlinkung | URL kann trotz Sperre indexiert werden | Seite wird zuverlässig aus dem Index entfernt |
| Voraussetzung | Datei im Stammverzeichnis | Seite muss crawlbar bleiben, damit der Tag gelesen wird |
| Einsatzbereich | Ganze Verzeichnisse, Crawl-Budget steuern | Einzelne Seiten dauerhaft aus der Suche nehmen |
Beide Methoden schließen sich nicht aus, dürfen aber nicht kombiniert werden: Blockiert robots.txt eine Seite, kann Googlebot den noindex-Tag auf dieser Seite gar nicht mehr lesen. Für eine zuverlässige Deindexierung muss die Seite crawlbar bleiben.
Robots.txt für KI-Crawler 2026 – Aktuelle Entwicklungen
Mit KI-Suchsystemen ist robots.txt wichtiger geworden. Entscheidend ist, wofür ein Bot crawlt:
| User-Agent | Anbieter | Zweck |
|---|---|---|
| GPTBot | OpenAI | Trainingsdaten |
| OAI-SearchBot | OpenAI | Inhalte für die ChatGPT-Suche |
| ClaudeBot | Anthropic | Trainingsdaten |
| PerplexityBot | Perplexity | Index für Perplexity-Antworten |
| Google-Extended | Nutzung für Gemini-Modelle; keine Wirkung auf AI Overviews und AI Mode | |
| CCBot | Common Crawl | offener Webkorpus, oft für KI-Training genutzt |
Wer in der ChatGPT-Suche zitiert werden will, darf OAI-SearchBot nicht sperren. AI Overviews und AI Mode laufen über den normalen Googlebot.
Google hat im April 2026 angekündigt, die Liste nicht unterstützter robots.txt-Regeln eventuell zu erweitern; als Grundlage dienen Daten aus dem HTTP Archive über häufig verwendete, aber nicht offiziell unterstützte Regeln. Website-Betreiber sollten ihre Datei regelmäßig daraufhin prüfen, ob sie auf nicht unterstützte Anweisungen wie Crawl-delay setzen, statt auf die vier offiziell dokumentierten Felder.
Häufige Fragen zu robots.txt
Was passiert, wenn eine Website keine robots.txt-Datei hat?
Fehlt die Datei, geht Google davon aus, dass keine Einschränkungen bestehen und crawlt die komplette Website. Das ist unproblematisch, allerdings fehlt dann die Möglichkeit, Crawler gezielt auf die Sitemap hinzuweisen oder einzelne Bots auszuschließen.
Blockiert robots.txt auch die Indexierung einer Seite?
Nein. Robots.txt verhindert nur, dass ein Crawler eine Seite abruft. Wird die URL über externe Links bekannt, kann sie trotzdem ohne Inhalt und ohne Snippet in den Suchergebnissen erscheinen. Für eine zuverlässige Entfernung aus dem Index ist der noindex-Tag notwendig.
Wo muss die robots.txt-Datei liegen?
Die Datei muss im Stammverzeichnis der Domain liegen, also unter www.beispiel.de/robots.txt. Eine Datei in einem Unterordner wie www.beispiel.de/seiten/robots.txt wird von Crawlern nicht berücksichtigt.
Kann man KI-Bots wie GPTBot über robots.txt blockieren?
Ja. Jeder Bot lässt sich mit einer eigenen User-agent-Zeile und Disallow: / sperren. Achte auf den Zweck: GPTBot zu sperren verhindert die Nutzung fürs Training, OAI-SearchBot zu sperren nimmt dich aus der ChatGPT-Suche. Google-Extended hat keinen Einfluss auf die Google-Suche und AI Overviews.
Muss jede Website eine robots.txt-Datei haben?
Zwingend erforderlich ist sie nicht, da Google auch ohne Datei crawlt. Sinnvoll ist sie trotzdem, um Crawler auf die Sitemap zu verweisen, das Crawl-Budget zu steuern und unerwünschte Bots gezielt auszuschließen.
Quellen
- Einführung und Leitfaden zu robots.txt-Dateien – Google Search Central, 2025
- Wie Google die robots.txt-Spezifikation interpretiert – Google for Developers, 2026
- robots.txt-Bericht – Google Search Console-Hilfe
Zuletzt fachlich geprüft am 27.10.2026 von Alexander Schneider. Zahlen und Produktfunktionen können sich ändern; die Quellen findest du oben.
Verwandte Begriffe im Glossar
Weiterführende Leistungsseiten
Zum Ratgeber: Schema-Markup-Leitfaden